Jev и LLM: где разница имеет значение
Вокруг Jev поднялся шум: модель не пишет тексты, а сразу выбирает вариант ответа и выдаёт вероятности. Но превращать языковую модель в классификатор умели и раньше: попросить один символ вместо ответа, например 0, 1 или 2, и взять logprobs этих токенов. Получится и метка, и оценка каждого класса.
Отсюда наш вопрос: что Jev даёт сверх этого приёма? Быстрее обрабатывает текст? Точнее выбирает ответ? Выдаёт вероятности, которым можно верить? Мы сравнили её с двумя обычными LLM на публичных данных, чтобы отделить измеримые преимущества от новизны подачи.
Это проверка готовых API, а не архитектуры. По ней можно судить о пользе Jev в похожих задачах, но нельзя установить, что у неё внутри.
Обновление 6 октября. В первой версии Qwen в режиме «17 вопросов за вызов» терял ответы, и мы записали это в слабости LLM. Причина оказалась в нашем формате: голый список из 17 цифр. С нумерованными ответами Q1: 0 сбои исчезли у обеих LLM, а качество на договорах поднялось выше Jev. Мы также посчитали, сколько стоят одиночные вопросы, если провайдер кэширует общий текст. Итог сдвинулся: Jev кратно быстрее и дешевле, но превосходства по качеству и вероятностям на договорах у неё нет.
Кого и как сравнивали
Jev — модель компании TypeSafe. Её API принимает текст и вопрос с набором вариантов (до 255), а возвращает выбранный вариант и вероятности по всем вариантам сразу. К одному тексту можно задать несколько вопросов в одном вызове: по документации текст обрабатывается один раз, а вопросы оцениваются независимо. Мы проверяем результат и скорость этого API, но не его устройство. Документация Jev · Контракт API.
LLM — DeepSeek V4.1 Flash и Qwen3.8 27B. Критерий выбора простой: доступные быстрые и недорогие API с рабочими logprobs и отключаемым reasoning. Мы не пытались выбрать самые точные LLM и не подбирали паритет по цене, размеру или железу, поэтому результат нельзя обобщать на все языковые модели. DeepSeek закреплён за Together, Qwen за Parasail через OpenRouter; Jev — родной API TypeSafe. Qwen3.8 27B · DeepSeek V4.1 Flash.
Baseline для LLM. Тот же текст и инструкция вернуть короткий код класса, без JSON Schema. Режимы отличаются. В бинарных и трёхклассовых одиночных опытах LLM генерирует один токен, и вероятность класса — это exp(logprob) его кода, нормированная на сумму вероятностей допустимых кодов. На BANKING77 код класса может состоять из нескольких токенов, и там сравниваем только метку. На 17 вопросов к одному тексту LLM возвращает нумерованные строки Q1: 0 … Q17: 2; вероятность каждого ответа берём из logprobs на позиции его цифры. В скоростном опыте раздела 02 LLM отдают короткие коды без logprobs, цена рабочего формата показана там же отдельно. У Jev берём поле probabilities.
Данные. ANLI — 300 коротких, но сложных выводов из текста: три класса. ContractNLI — 30 договоров, к каждому 17 утверждений, всего 510 пар текст/утверждение: подтверждено, противоречит, сведений недостаточно. BANKING77 — 385 обращений в банк, по 5 на каждое из 77 намерений. Все три набора публичные и англоязычные.
Четыре проверки
- Качество выбора метки. Три задачи, macro-F1. Специализация Jev могла дать более точные ответы, но LLM могли оказаться не хуже. → 01
- Скорость на многих вопросах. Jev штатно берёт несколько вопросов к тексту. Но LLM тоже можно дать 17 вопросов в одном промпте или отправить 17 запросов параллельно, а общий текст провайдер может взять из кэша. Проверяем, остаётся ли преимущество по времени и по деньгам. → 02
- Меньше ложных тревог. Отдельный бинарный опыт на ContractNLI: есть противоречие или нет. Сравниваем precision при одинаковом recall, чтобы не путать качество с привычкой чаще отвечать «да». → 03
- Вероятности, которым можно верить. На тех же бинарных ответах: если модель обещает 80%, противоречие должно встречаться примерно в 80% таких случаев. Плюс трёхклассовые вероятности, когда все 17 вопросов идут одним вызовом. → 04
Обратите внимание: ContractNLI участвует дважды. В разделе 01 это трёхклассовая задача, где проверяем метку. В разделах 03 и 04 это отдельный бинарный прогон по тем же 510 парам, где проверяем score. Это не одни и те же ответы, схлопнутые в два класса.
01 Где лучше качество
Macro-F1, выше лучше. Каждый класс весит одинаково, поэтому редкие классы не теряются.
| Публичный поднабор | Jev 1.13 | DeepSeek V4.1 Flash | Qwen3.8 27B |
|---|---|---|---|
| ANLI · 300 · один вопрос | 0.779 | 0.676 | 0.661 |
| ContractNLI · 510 · один вопрос | 0.734 | 0.689 | 0.760 |
| ContractNLI · те же 510 · 17 вопросов за вызов | 0.731 | 0.788 | 0.807 |
| BANKING77 · 385 · 77 классов | 0.773 | 0.654 | 0.769 |
Jev выше на ANLI. На договорах выше LLM: Qwen — на одиночных вопросах, обе LLM — когда все 17 вопросов идут одним вызовом. На BANKING77 Jev и Qwen близки. Общего рейтинга нет: задачи разные, и победитель зависит от задачи.
Формат ответа решает. В первой версии LLM возвращали 17 кодов подряд через пробел. В 9 из 30 вызовов Qwen выдала 15–16 кодов вместо 17: модель теряла счёт, и весь вызов засчитывался ошибкой. Отсюда macro-F1 0.582 в прошлой версии таблицы. Повтор 6 октября это подтвердил: сбои в 16 из 60 вызовов у Qwen и в 2 из 60 у DeepSeek. Мы проверили два исправления. Первое — пронумеровать вопросы и просить строки Q1: 0. Второе — strict JSON Schema, где у каждого вопроса только допустимые коды. Оба убрали сбои полностью: 0 из 240 вызовов. Нумерация не хуже по качеству (Qwen 0.807 против 0.796 со схемой, DeepSeek 0.788 против 0.780), короче на выходе и не ломает logprobs. У DeepSeek через Together JSON Schema вероятности не возвращает вовсе. В таблице — нумерованный формат.
Пакет оказался лучше поштучных вопросов. У обеих LLM 17 вопросов за вызов дали более высокий macro-F1, чем по одному вопросу. Qwen: +0.05, 95% интервал [+0.01; +0.09]. DeepSeek: +0.09, [+0.05; +0.13]. Интервалы получены bootstrap-ом по договорам. Причину мы не исследовали. Правдоподобная версия: соседние утверждения помогают отличить «не сказано» от «противоречит». У Jev такого эффекта нет (0.734 по одному и 0.731 пакетом), но одинаковая метрика ничего не говорит о механизме: независимость вопросов остаётся словами поставщика. Разница с Jev в пакетном режиме значима: Qwen +0.08 [+0.04; +0.11], DeepSeek +0.06 [+0.02; +0.10]. Пакетный режим всех трёх моделей перемерен 6 октября с одного сервера; одиночные вопросы — 21–24 сентября.
Про полный вектор вероятностей. На BANKING77 сравниваем только метки. Jev отдаёт вероятности всех 77 вариантов сразу; у выбранных LLM top-20 logprobs этот вектор не покрывает, а код класса может состоять из нескольких токенов.
02 Два способа ускорить одну и ту же работу
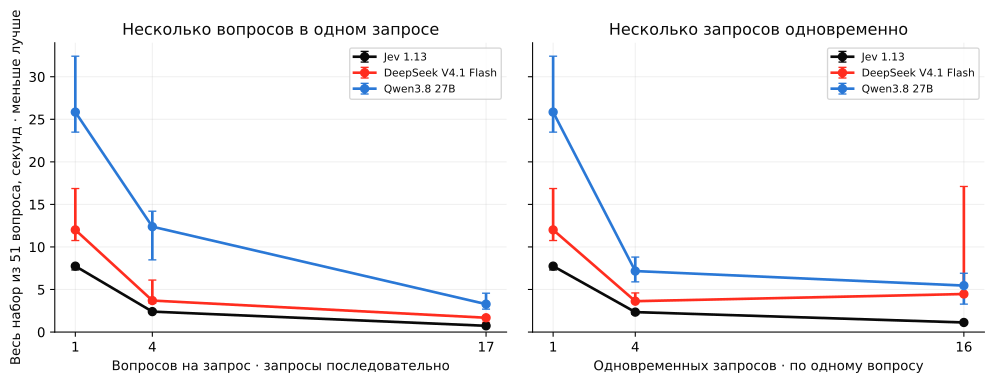
Работа одна: 51 решение — 17 вопросов к каждому из трёх договоров. Ускорить можно двумя способами. Слева на графике вопросы упакованы в один вызов: 1, 4 или 17 вопросов на запрос, запросы подряд. Справа каждый вопрос — отдельный запрос, а параллельно уходит 1, 4 или 16 запросов. Числа 16 и 17 не связаны: 17 — утверждений в договоре, 16 — просто уровень нагрузки в сетке. По оси Y — время завершения всего набора, точки — медиана трёх повторов, полоски — минимум и максимум.
| Модель | По одному, подряд · с | По 17 в запросе · с | По одному, 16 одновременно · с |
|---|---|---|---|
| Jev 1.13 | 7.75 | 0.73 | 1.12 |
| DeepSeek V4.1 Flash | 12.01 | 1.68 | 4.47 ‡ |
| Qwen3.8 27B | 25.85 | 3.28 † | 5.46 |
Jev быстрее в каждом измеренном режиме. У всех трёх 17 вопросов в одном вызове дали минимальное время: контекст передаётся один раз. Параллельные одиночные запросы тоже помогают, но контекст уходит повторно; сколько здесь экономит кэш провайдера, посчитано ниже. Такой параллелизм доступен всем трём API, поэтому нельзя сравнивать многовопросный Jev с последовательными вызовами LLM и весь выигрыш приписывать модели. Это замер на трёх договорах, на другие нагрузки его не переносим.
Что именно измерено. Полное время ответа API с одного сервера в США (IP 107.172.73.82), без SSH. Сеть, очереди, cache и вычисления провайдера здесь не разделить, первые соединения включены. LLM в этом опыте отдают коды без logprobs, а Jev — вероятности штатно; скорость выдачи полного вектора вероятностей у LLM не измерялась.
Сноски. † Qwen: в режиме 17 вопросов 1 из 9 вызовов вернул неполный набор кодов; время учтено, качество здесь не оценивается — оно в таблице macro-F1. ‡ DeepSeek: в режиме 16 параллельных запросов часть первых попыток получила HTTP 503. Всего по скоростной серии у DeepSeek 4 таких ошибки на 513 вызовов во всех режимах и повторах, у Jev и Qwen 0 на 513. Время первой попытки включено в замер, диагностический повтор исключён.
Рабочий формат и кэш. График выше снят на коротких кодах, которые у Qwen теряли ответы. Нумерованный формат длиннее: около 6 выходных токенов на вопрос вместо 2. Поэтому 6 октября мы отдельно замерили цену рабочих вариантов: тот же сервер, все 30 договоров.
| На один документ, 17 решений | Время, p50 | $ за 1000 решений |
|---|---|---|
| Jev 1.13 · 17 вопросов за вызов | 0.21 с | $0.013 |
| DeepSeek · 17 вопросов, нумерованный ответ | 0.43 с | $0.076 |
| DeepSeek · по одному вопросу: 1 + 16 параллельно, с кэшем | 2.9 с | $0.104 |
| Qwen · 17 вопросов, нумерованный ответ | 2.7 с | $0.070 |
| Qwen · по одному вопросу: 1 + 16 параллельно, с кэшем | 4.4 с | $0.251 |
Кэш помогает поштучному режиму, но пакет не обгоняет. В одиночном вопросе общий префикс — инструкция и договор — занимает 94% промпта у DeepSeek и около 78% у Qwen. Провайдер может взять его из кэша; первый вызов по документу платит полностью. Без кэша 17 одиночных вызовов стоили бы $0.78 и $0.63 за 1000 решений. Кэш удешевляет их в 7 раз у DeepSeek, где чтение из кэша в 50 раз дешевле обычного входа. У Qwen — в 2.5 раза: там кэш дешевле обычного входа только в 5 раз. Пакет же отправляет договор один раз и всё равно не дороже.
По скорости кэш сокращает последовательный одиночный вызов DeepSeek с 291 до 156 мс, у Qwen — с 893 до 707 мс. В параллельной пачке этот выигрыш съедают очередь и хвосты. У Qwen 17 из 480 параллельных вызовов получили HTTP 429: провайдер упёрся в лимит запросов.
Цена LLM посчитана по токенам и прайсу закреплённых эндпоинтов OpenRouter на 6 октября. Пакет считается без кэша: в продакшене документ отправляется один раз. Цена Jev — по usage: входные токены × $0.042 за 1M. Время — до полного ответа; у LLM в пакете это первый, холодный вызов по документу.
03 Меньше ложных тревог при нужном recall
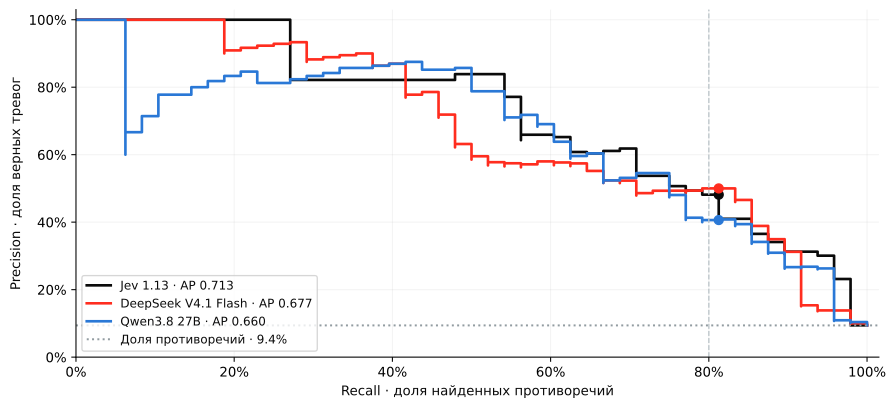
Задача — найти противоречие в договоре. Здесь отдельный бинарный опыт: те же 510 пар, тот же вопрос всем трём моделям с двумя вариантами ответа. Противоречий 48 из 510 (9.4%), подтверждённые и неизвестные утверждения — класс «нет противоречия». Модель выдаёт вероятность противоречия; этот score используется и здесь, и в разделе 04.
Recall: сколько настоящих противоречий нашли. Precision: какая доля тревог верна. Каждый порог даёт свою точку на кривой; при нужном recall выбираем кривую выше — она даёт меньше ложных тревог.
| Модель | Average Precision ↑ | Precision при recall 81.25% | Верные / ложные тревоги |
|---|---|---|---|
| Jev 1.13 | 0.713 | 48.1% | 39 / 42 |
| DeepSeek V4.1 Flash | 0.677 | 50.0% | 39 / 39 |
| Qwen3.8 27B | 0.660 | 40.6% | 39 / 57 |
Точку recall ≈ 80% мы выбрали как иллюстративный рабочий ориентир, не как требование продукта. На выборке ближайший достижимый шаг у всех трёх — 39 из 48 противоречий, 81.25%, без интерполяции. При другом требуемом recall соотношение кривых меняется, поэтому смотрите на всю кривую, а не только на точку 80%. Порог на тестовой кривой описывает этот тест, а не готовый production-порог.
Average Precision сводит всю кривую в одно число. У Jev оно численно выше на этой выборке, но это не выигрыш в каждой точке.
Насколько это надёжно. Интервалы считали bootstrap-ом по целым договорам. Precision в выбранной точке: DeepSeek − Jev = +1.9 п.п., 95% интервал [−13.2; +14.3]; Qwen − Jev = −7.5 п.п., [−20.9; +13.7]. AP: DeepSeek − Jev = −0.037, [−0.102; +0.025]; Qwen − Jev = −0.053, [−0.120; +0.028]. Все интервалы включают ноль: статистический победитель не установлен ни по AP, ни в выбранной точке. Равенство этим тоже не доказано — выборка просто мала. Что видно без статистики: около выбранного recall у Jev и DeepSeek примерно половина тревог ложная. Удобный API сам по себе проблему качества не решает.
04 Можно ли верить вероятностям
Большое число ещё не значит надёжную вероятность. Здесь те же бинарные score, что и в разделе 03: p — вероятность противоречия, не вероятность того, что модель права. Если модель выдаёт 0.8, среди многих таких случаев противоречие должно встречаться примерно в 80%. На графике диагональ — идеальное совпадение; точка ниже диагонали означает, что модель завышает вероятность противоречия. Числа у точек — размер группы.
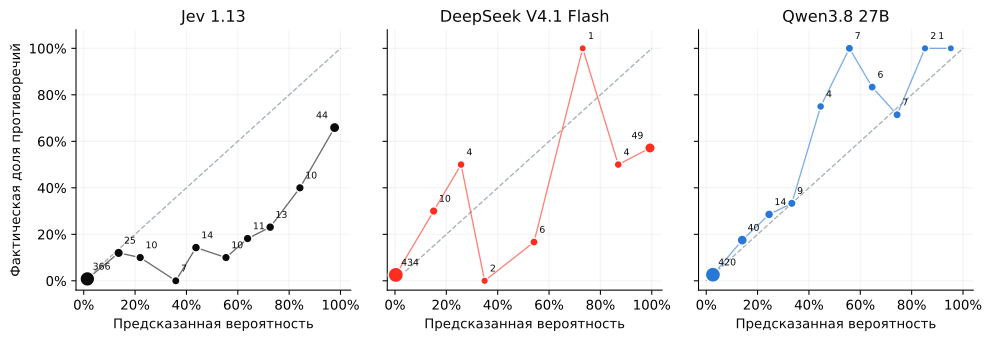
Монотонность — отдельное полезное свойство. Чем выше предсказанная вероятность, тем чаще должно встречаться противоречие. Для этого кривая должна в целом расти; для хорошей калибровки — ещё и попадать на диагональ. Поэтому модель может завышать вероятности, но всё же давать полезный сигнал: «здесь риск выше, здесь ниже».
У Jev этот рост визуально ровнее, чем у DeepSeek: начиная с группы 50–60%, фактическая частота последовательно растёт от 10% до 66% в верхней группе. Но строгой монотонности на всём диапазоне нет и у Jev. У Qwen тоже виден общий рост с локальными спадами. Скачки DeepSeek выглядят резче, однако часть точек построена всего по 1–4 примерам: например, 100% в группе 70–80% — это одно противоречие из одного случая. Поэтому более ровная кривая Jev — обнадёживающее наблюдение на этой выборке, а не доказанное преимущество. Она также не заменяет PR-кривую: та проверяет полезность ранжирования без такого разбиения на группы.
Самая уверенная группа, p ≥ 90%. Jev: обещано 97.7%, противоречие в 65.9% случаев, 44 примера. DeepSeek: 99.3% → 57.1%, 49 примеров. Обе модели в этой зоне заметно самоуверенны. У Qwen в этом диапазоне один пример — судить не по чему.
| Модель | Brier ↓ | ECE ↓ |
|---|---|---|
| Jev 1.13 | 0.081 | 8.8 п.п. |
| DeepSeek V4.1 Flash | 0.075 | 7.3 п.п. |
| Qwen3.8 27B | 0.050 | 1.6 п.п. |
Brier — среднее (p − y)², где y = 1, если противоречие есть. Ориентир для масштаба: постоянный прогноз 9.4%, то есть частота противоречий в этой же выборке, даёт Brier 0.085. Jev и DeepSeek выигрывают у него немного, Qwen — заметно. Но постоянный прогноз не отличает один случай от другого, поэтому малый Brier не отменяет пользу ранжирования из раздела 03.
ECE — средний разрыв между обещанной вероятностью и реальной частотой по десяти группам, с весом по числу примеров. Редкие группы шумные: у Qwen почти все примеры лежат в нижней группе, и низкий ECE во многом оттуда.
Qwen лучше по Brier и ECE, хотя ниже по AP. Это разные свойства: можно аккуратно оценивать вероятность и при этом давать больше ложных тревог при требуемом recall. Всё это исходные числа моделей без посткалибровки; посткалибровка за рамками отчёта, и мы не обещаем, что она что-то исправит.
Вероятности в пакетном режиме. Пакет не отнимает у LLM вероятности. Каждая цифра ответа — отдельный токен, и logprobs на её позиции дают распределение по трём классам для каждого из 17 вопросов. Трёхклассовый ContractNLI, все 510 пар, все вопросы к договору одним вызовом:
| 17 вопросов за вызов | Brier ↓ | ECE ↓ |
|---|---|---|
| Jev 1.13 | 0.328 | 8.5 п.п. |
| DeepSeek V4.1 Flash · нумерованный ответ | 0.277 | 9.9 п.п. |
| Qwen3.8 27B · нумерованный ответ | 0.226 | 7.3 п.п. |
Здесь Brier — сумма квадратов ошибок по трём классам, поэтому с бинарной таблицей выше его не сравнить. По Brier обе LLM в пакете лучше Jev, по ECE Qwen лучше, DeepSeek немного хуже. У DeepSeek в пакете вероятности даже заметно аккуратнее, чем на одиночных вопросах: там Brier 0.46 при сильной самоуверенности. Это одна задача и один прогон; калибровочные кривые для пакета мы не строили.
05 Что выяснили и чего не доказали
Где преимущество Jev видно
Скорость. Jev быстрее в каждом проверенном режиме. На документ из 17 вопросов — 0.21 с против 0.43 с у DeepSeek и 2.7 с у Qwen в рабочем формате. Это время API-маршрута, а не чистые вычисления модели.
Цена. $0.013 за 1000 решений против $0.07–0.08 у LLM в пакетном режиме — примерно в 5 раз дешевле. Одиночные вопросы у LLM даже с кэшем стоят ещё дороже.
Удобство. Несколько вопросов к тексту и полный вектор вероятностей — штатный режим, без подбора формата ответа. Мы сами на этом споткнулись: голый список кодов терял ответы, и первая версия этого отчёта ошибочно записала это в слабости Qwen. На 77 классах Jev возвращает вероятности всех вариантов; выбранные LLM с top-20 logprobs этого не дают.
Где общего превосходства нет
Качество зависит от задачи. Jev выше на ANLI. LLM выше на договорах, особенно в пакетном режиме: 0.79–0.81 против 0.73, интервалы разницы не включают ноль. На BANKING77 Jev и Qwen близки.
Вероятности Jev не лучше автоматически. В бинарном опыте AP у Jev численно выше, но интервалы включают ноль; по калибровке лучше Qwen. В 17-вопросном режиме обе LLM по Brier лучше Jev. Уверенные ответы Jev заметно завышены.
Что это значит для «новизны»
Классификация с вероятностями сама по себе не новая возможность: наш простой baseline «LLM + logprobs» работает. Но и списывать Jev на маркетинг нельзя: в этих замерах есть кратный выигрыш по скорости и цене и удобный интерфейс с полным вектором вероятностей. Ни новую архитектуру, ни универсальное превосходство, ни равенство с LLM мы не доказали. Практический выбор — по своей задаче: скорость и удобство отдельно, точность и надёжность вероятностей отдельно.
Есть и практический пробел в LLM API. Приём «один токен + logprobs» требует доступа к вероятностям токенов, а у ряда новых моделей его нет в доступном API. Например, при проверке каталога OpenRouter 1 октября 2026 года у Gemini 3.8 Flash и Claude Sonnet 5.5 параметры logprobs и top_logprobs не заявлены; у выбранных DeepSeek и Qwen они есть. Даже там, где logprobs заявлены, они бывают хрупкими: у DeepSeek через Together они пропадают, как только включаешь JSON Schema. Это ограничения конкретных API, а не способности моделей классифицировать. Поддерживаемые параметры моделей · Каталог API.
В этом смысле Jev и подобные специализированные модели закрывают реальную потребность: возвращают оценки всех заданных вариантов через интерфейс, прямо предназначенный для классификации и нескольких вопросов к тексту. Не нужно искать подходящую пару модель/провайдер, сопоставлять классы с токенами и проверять, поместились ли они в top-k. Новизна здесь может быть в доступности и удобстве уже знакомой возможности — даже без универсального выигрыша по качеству и без гарантии калиброванных вероятностей.
Если всё же берёте LLM. Все вопросы к документу — одним вызовом, вопросы и ответы — с явными номерами, число ответов — проверять. Вероятности брать из logprobs на позициях цифр. Одиночные вызовы с кэшем имеют смысл, только если нужна независимость вопросов друг от друга: на договорах они оказались и хуже, и дороже пакета.
Границы опыта. Две LLM выбраны по доступности, рабочим logprobs и отключаемому reasoning, а не как самые точные; на все LLM результат не обобщается. Публичные англоязычные поднаборы могли попадать в предобучение. Бинарные вероятности проверены только на ContractNLI: 30 договоров, 48 противоречий; разметку не меняли. Замеры качества Jev и DeepSeek — 21–22 сентября, Qwen — 24 сентября, скоростная серия — 24 сентября. Пакетный режим всех трёх моделей, кэш и цены — 6 октября; в тот день API Jev несколько минут отвечал HTTP 503, замер сделан после восстановления. Сравниваются доступные API-маршруты, не одинаковое железо.
Полные метрики и score · Таблица качества CSV · Протокол · Проверка сырых ответов · Формат ответа и кэш, 6 октября. Данные: ANLI, ContractNLI, BANKING77.